DeepSeek近期对App与网页版的长对话能力作出调整,涉及历史对话保留时长、单次输入长度以及每日可用额度。据用户反馈,这轮变化与平台当前的算力资源承载压力有关,属于服务侧的容量管理措施。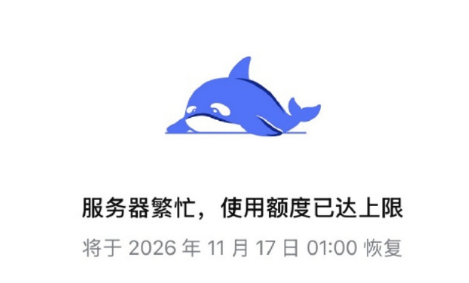
三项调整的具体内容
第一项变化针对历史对话。超过7天未活跃的长对话不再保留,用户此前长期挂起的会话需要重新建立上下文。第二项变化针对单次提问的输入长度,文字上限下调至约4万字,长文档一次性提交的做法因此受到约束。第三项是新增每日对话额度,当使用量达到上限时,界面会提示“因服务器繁忙,使用额度已达上限”,并暂时阻止用户继续对话。
提示语将原因指向服务器繁忙,说明限制的直接触发条件是资源紧张,并非产品策略转向付费。
长对话为何最消耗资源
多轮对话与超长上下文会明显推高推理成本。每增加一轮交互,模型都要重新处理此前累积的上下文,输入量随对话轮次增长而膨胀;4万字量级的输入意味着单次请求就要完成大量文本的编码与注意力计算。历史会话长期留存,也会持续占用存储与检索资源。把这些环节纳入额度管理,是平台在用户规模扩大后较常见的做法。
从成本结构看,长上下文带来的开销并非线性增长。会话越长,重复计算的部分越多,单位提问所对应的算力消耗也越高。平台若不对这类高频、长时的使用方式加以约束,资源容易被少数超长会话占据,进而影响其他用户的正常调用。
供给与需求之间的平衡题
随着AI应用日活与交互频次上升,算力供给很难与调用需求的增长速度保持同步。平台通常有三条路径:通过资源调度把峰值压力分散到不同时段;通过推理效率优化降低单次调用成本;通过服务分级区分高频与普通用户的需求。任何一条路径都会在产品体验上留下痕迹,限制条款因此成为显性的调节工具。
对DeepSeek而言,此次调整把成本约束在用户使用规则中体现:历史对话有生命周期,单次输入有上限,每日调用有配额。相比直接缩减模型能力或暂停新用户注册,这类做法对整体服务连续性的冲击更小,也更容易在现有架构下执行。
用户需要做哪些适应
依赖长文档分析的用户,需要把材料拆分成分批输入,或在提问前先做摘要压缩,避免单次超过4万字。习惯用同一会话追溯早期内容的用户,应及时导出或另行保存关键结论,7天不活跃即可能失去上下文。每日额度用尽后,只能等待额度恢复,重要任务应尽量安排在额度充足时完成。
对团队用户来说,把握示长任务拆解为多个短会话、把稳定结论保存到外部文档,是降低额度消耗的直接方式。平台侧是否会公布更细的额度规则、是否提供更高配额选项,目前尚无进一步说明。
要点回顾
- 历史对话:超过7天未活跃的长对话不再保留。
- 输入长度:单次提问文字上限约4万字。
- 每日额度:新增对话额度,达到上限后提示服务器繁忙并暂停使用。
- 触发原因:用户反馈指向算力资源承载压力,官方未披露具体数值。
- 应对方式:分批输入、及时留存结论、错峰安排高消耗任务。