大模型项目需要同时衡量调用成本、业务效果与数据合规,单看模型参数或演示效果容易失真。
核心观察
评估 AI 项目时,建议把人工节省、响应速度和内容质量折算为可比较的指标,同时预留数据安全与内容审核成本。
对从业者的启示
从实际落地看,工具和平台只是起点,真正的差异来自流程设计、数据质量与持续运营。建议结合自身业务目标,先在小范围场景验证,再逐步扩大应用范围。
关于本栏目
本文为AI前沿栏目内容示例,用于展示资讯分类、列表与详情页排版。欢迎通过投稿入口提交行业观察、产品动态与实践经验。
大模型项目需要同时衡量调用成本、业务效果与数据合规,单看模型参数或演示效果容易失真。
评估 AI 项目时,建议把人工节省、响应速度和内容质量折算为可比较的指标,同时预留数据安全与内容审核成本。
从实际落地看,工具和平台只是起点,真正的差异来自流程设计、数据质量与持续运营。建议结合自身业务目标,先在小范围场景验证,再逐步扩大应用范围。
本文为AI前沿栏目内容示例,用于展示资讯分类、列表与详情页排版。欢迎通过投稿入口提交行业观察、产品动态与实践经验。
暂无建议。
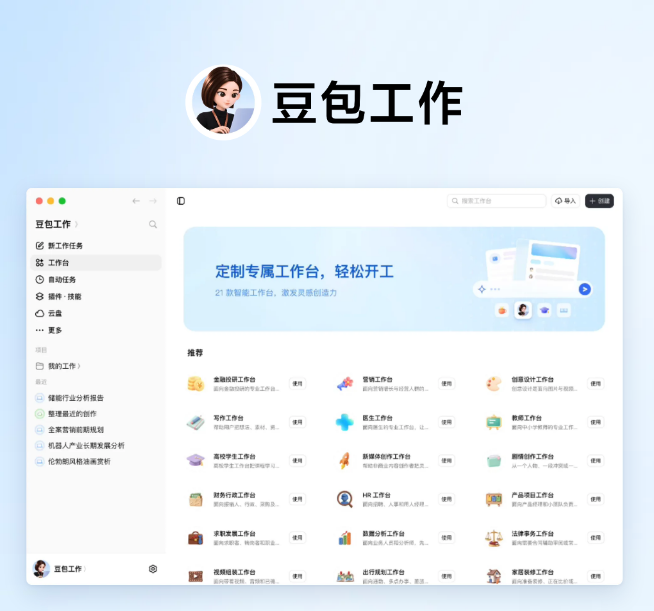
豆包11月16日在豆包工作中上线「工作台」功能,首批覆盖金融、医疗、教育、创意设计等21个专业场景。工作台预设技能与工具,降低专业场景AI使用门槛;金融投研打通万得、同花顺等数据服务,教师工作台与学科…
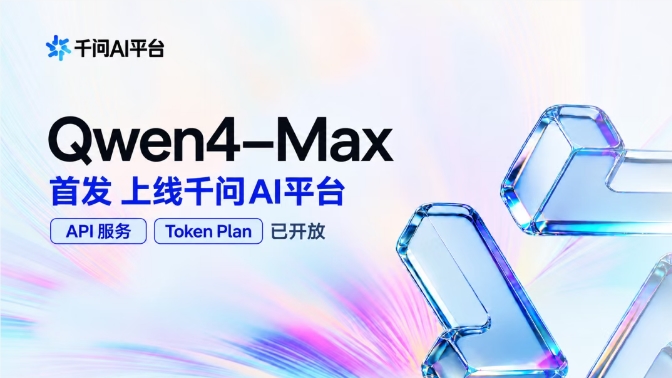
阿里巴巴11月16日发布Qwen4,千问AI平台首发Qwen4-Max并开放API与Token Plan。模型采用QSA稀疏注意力MoE架构,支持百万上下文。Terminal-Bench4.0中Tok…
11月15日,腾讯WorkBuddy国际版接入谷歌Gemini4Carbon大模型,面向复杂推理与长周期任务,仅向Pro用户开放。该模型支持文本、图像、音频、视频多模态输入,上下文最高100万Toke…
DeepSeek对App与网页版的长对话能力作出调整:超过7天未活跃的历史对话不再保留,单次提问文字输入上限降至约4万字,并新增每日对话额度。用户反馈称,额度用尽后会提示“因服务器繁忙,使用额度已达上…